作者归档:Young

《事务处理原理》


概述

年中参与了一个售卖系统的开发工作,开发过程中涉及较多的数据库事务操作以及多层系统之间的状态同步问题。对于事务大方向上的理解,个人觉得需要加强。

查阅相关书籍,发现首推的都是Jim Grey编写的《事务处理》。此书虽然经典,但是篇幅较大(800+页),希望快速了解一些共性原理的情况下,同事推荐了这本《事务处理原理》。

在工作之余,挑选了自己较为关注的章节进行阅读并做了一些笔记。

分章节笔记

第1章 简介

事务处理(Transaction Processing, TP)

对于真实世界中的交换产生的记账行为,通过网络连接起来计算机进行处理。

在线事务(Online Transaction)

在线用户执行程序,操作数据库。

ACID

原子性(Atomicity):事务或全部执行,或不执行,

一致性(Consistency):事务保持数据库的内部一致性

隔离性(Isolation):每个事务不影响其他事务

持久性(Durability):故障发生时事务不丢失

通过ACID测试才能称之为一个事务系统。

原子性(Atomicity)

成功称为提交commit,事务异常终止则是abort。

对于已提交的事务发现错误的,需要有事务补偿(compensating transaction)机制,考虑到任何事务都有可能失败,设计良好的TP系统需要对各类事务有补偿机制。但是补偿仍有可能不够完备,可以通过其他策略进行修正。

一致性(Consistency)

数据库事务的一致性指的是“内部一致性”,即满足所有逻辑上的约束,不能出现不合理的值。

一致性不仅仅需要事务系统负责,更需要应用程序参与,而且应用程序负主责。

隔离性(Isolation)

隔离性的关键是可串行化。即执行事务集和按顺序逐个执行事务结果一致。

加锁机制是大多数数据库系统保持隔离性的一种方法。

持久性(Durability)

事务执行完成,并一定存入稳定存储器,才能称作实现了持久性。

持久性的主要实现方式之一即将事务更新的副本追加到日志文件中获得的,事务提交时,系统会确保写入日志已经写入磁盘,之后返回给应用程序事务已被提交。如果是数据库程序,实际入库时机不定。事务系统崩溃之后,会通过日志进行恢复,且必须通过日志进行恢复。

两阶段提交(2PC two-phase commit)

解决涉及多个数据库系统的数据不同步的问题。

由事务管理模块控制。执行两阶段提交时,事务管理器发出两轮消息,第一轮通知所有资源将事务结果写入稳定存储中,所有资源均确认已写入后,发出第二轮消息,通知资源管理器实际提交事务。写入的数据量要足以恢复提交前的状态。

第2章 事务处理抽象

集合事务(Transaction Bracketing)

个人理解:集合事务是一组标准的编程模式,提供启动(Start)、提交(Commit)与异常终止(Abort)三个事务命令。

组合事务的两种解决方法

  • 实现Start时只执行第一个Start操作,实现Commit操作时只执行最后一个Commit操作
  • 实现每一个事务组合实现包装器代码,在包装器中进行Start/Commit操作,事务操作编写为元方法

事务标识符

每个事务都应该有个唯一的事务标识符,启动时分配,通过标识符关联全部事务操作。

嵌套事务

嵌套事务在大多数商用系统中不被支持,其表示模式如下:

  • 事务中使用Start命令,则这一事务是其所在事务的子事务
  • 不在事务中使用Start,则这一事务成为顶级事务
  • 顶级的Commit和Abort操作可以影响子事务
  • 子事务Abort只通知父事务,父事务酌情处理
  • 子事务之间是隔离的

必备的异常处理

事务故障的恢复,系统故障恢复。

保存点(Savepoints)

保存点是通过通知资源记录操作完成状态实现回退部分事务的一种机制。保存点只会保存顶级事务带来的影响,当子事务调用保存点记录状态时,子事务存在并发操作的情况下,使用保存点无法回退单一子事务带来的影响。

第3章 事务处理应用程序体系结构

事务处理系统的影响因素

  • 组件是否共享地址空间
  • 地址空间是否有多个线程中的一个线程在执行
  • 是否有硬件、OS或者语言机制保护共享地址空间的程序,免于意外修改内存

事务中间件

提供了API以及各类工具,提供与DB和应用程序的交互功能,对开发人员屏蔽事务操作中的操作系统级别的问题,如多线程、通信和安全性。

存储过程VS事务服务器/中间件

存储过程可以完成事务服务器的工作,然而为什么事务服务器/中间件仍然有市场?

原因在于:

  • 数据库对于新的通信协议、特性的添加相当缓慢且稳定
  • 事务服务器/中间件对开发者更友好(语言,特性,规避问题)
  • 事务服务器可水平扩展性远优于数据库(通过事务服务器更容易扩容)

第4章 队列化的事务处理

队列化的事务处理

  • 队列分为请求队列以及应答队列
  • 队列必须写入到非易失性存储之中
  • TP程序从请求队列获取任务,处理后写入应答队列
  • 客户端和服务端需要在会话中提供足够的上下文,用于恢复和按序处理

队列化的事务处理对于不可撤销操作的处理

对于输出,如果只是涉及到非实物的情况,那么影响并不大。

但是当涉及金钱出入等问题时,需要处理,方法是在出应答队列之前先写入日志,如果没有前期的写入日志的情况,那么说明并没有执行过这一步骤,如果存在,需要人工告知或者通过其他手段确认到底是否可以执行这一操作。总而言之,即先记录动作,再实际操作(带来的问题可能是对用户的不良体验,但是保证了TP系统不会遭受损失)。

个人理解:比如ATM出钞操作,步骤如下:

  1. 由于已经扣款,那么取款机启动一个事务,从应答队列中,取出此次取款操作的返回值,即成功取款;
  2. 本地查看是否有本次取款的物理出钞记录,没有则进行到3,有则终止
  3. 记录本次出钞
  4. 实际打开取钞盒,吐出钞票
  5. 提交事务

第6章 锁定

两阶段锁定(two-phase locking)

一个事务必须在释放其获得的锁之前得到他的锁定。

目的在于不留出因为先解锁后加锁带来的可供其他事物修改已锁定目标的时间段。两阶段锁定生效的有效的前提是事务只通过事务内读取和写入两种操作进行交互,如果借助了其他手段,那么会破坏可靠性。

如果一个执行中的事务都遵循两阶段锁定,此执行就是可串行化的。

死锁解决的唯一方法

终止死锁涉及到的事务之一。

死锁检测的技术

基于超时与基于图形的检测。

基于超时的检测易于实现,但是可能会终止实际上并没有死锁的事务,同样的由于基于时间进行控制,也会让死锁持续过久。

基于图形的检测,通过等待图(waits-for graph)这一工具进行,从直观上,节点表示事务,边根据方向A->B,表示A上等待着B上的一个锁定被解除,当锁定解除时,边会被删除,当出现闭环时,说明存在死锁。检查可以是定期检测。同时,基于图形的死锁检测同时也可以在边上设定允许的等待时间,超时的循环存在则可以有效的检验死锁。

然而基于超时的检测并非一无是处,在异构拓扑,以及分布式网络环境中,效果较好。

死锁牺牲品的选择

  • 产生了循环的事务(最易于发现)
  • 锁数量最少的事务(完成最少工作量)
  • 生成日志最少的事务(成本最低)
  • 写入锁数量最少的事务(成本最低)

死锁的循环式重新启动问题(cyclic restart)

被牺牲的事务因为重新启动又触发死锁,导致无法进行。解决办法是可以将启动时间作为牺牲的考虑因素,牺牲最晚出现的事务。

死锁触发的因素

  • 锁转换(lock conversion):多个事务同时要求将同一位置上的读锁转换为写锁,由于两阶段锁定的限制,需要先解锁读锁,但是多个事务互相等待其他事务上读锁的释放,于是死锁;解决方法是对于影响范围先上写锁,确定不需要更改时降级为读锁定,或者使用不和读锁冲突的共享锁模式,先上共享锁,会比先上写锁的方式提高一定并发度。共享锁因为和读锁不冲突,不需要进行解锁等操作,所以不会触发死锁。
  • 锁抖动(lock thrashing):启动太多事务,由于请求锁的数量倍增,会阻塞住大量事务,造成吞吐量减小的情况。

第7章 系统恢复

系统故障的衡量指标MTBF与MTTR

MTBF即Mean Time Between Failures,即系统出现故障前的平均运行时间,MTTR则是Mean Time To Repair,即系统出现故障之后进行修复所用时间。

可用性可以定义为MTBF/(MTBF+MTTR)。

TP系统服务端恢复的原则

非幂等的操作,恢复时对于没有完成的任务需要执行完成,而不是重试。

系统恢复的关注点应该是已执行的事务,这样会简化系统恢复(基于事务的服务器恢复无需复制运行时内存状态,只需通过增量的改动日志进行恢复,不完整的事务不会被理会)。

基于保存点的非幂等操作服务端恢复

基于保存点的非幂等操作的服务端恢复,需要在执行非幂等操作之前,将内存状态保存到非易失性存储中。

这样操作可以使得系统在恢复过程中确定执行非幂等操作时数据的状态,以便从指定的时间点完成任务,防止出现错误的重复操作。

数据库的故障类型

  • 事务故障:事务运行异常
  • 系统故障:主存发生问题
  • 媒介故障:持久化存储器发生问题

数据库的恢复策略

  • 事务故障:恢复到事务执行之前的数据状态
  • 系统故障:中断所有未提交的事务,保证写入已提交事务的结果
  • 媒介故障:与系统故障基本相同

数据库错误恢复的日志格式要点

  • 被更新的页面地址
  • 执行更新事务的标识符
  • 页面被写入后的值(后像)
  • 页面被写入前的值(前像)
  • 冲突操作的实际执行顺序

数据库恢复管理器应该具有的三大操作

  • 提交:原子的将更新后数据写入数据库,不可撤销
  • 中断:将事务带来的数据影响还原,不可撤销
  • 重启:中断故障时所有未提交的的事务,写入已提交的事务尚未同步到数据文件中的数据。这一个操作必须是幂等的

预写日志协议

先改动数据文件,后写入前像日志,在第二步出现错误时,系统恢复,会引起前像丢失的问题,无法恢复。

预写日志协议的定义是:不要讲未提交的更新输出到稳定数据库中,直至其前像日志记录被输出到日志之中。

通过这一方式,数据库可以实现异常终止,明确恢复时可以关闭的事务,以及需要补充写入数据文件的部分。

No-Steal方法是一个简化的规避上述问题的方法,即未提交的改动全部记录到日志之中,事务提交之后才将改动写入到DB之中(问题:如何保证提交之后,数据写入稳定存储和其他事务读取了正确的数据?事务已提交,结果就能被读取,未写入到稳定存储中,也需要能被读取?)。

提交时的强制规则

与预写日志协议相冲突,这一规则的定义为:在事务所有已更新数据的后像写入到稳定存储之前,不能提交事务。

故障恢复方法(Shadow-paging)

核心思想是维护两份数据,数据库中的数据只存储已提交的事务,提交事务的操作即将数据指向已写入稳定存储中的状态副本(shadow page)。

所谓Shadow page可以看做是数据的目录,会指向实际的数据页面文件,在Shadow page完成指向之后,数据库会更换shadow page的指向,之前的关联关系就会被废弃。

中断事务因为没有做实际的改变(指向关系没有变动),所以可以直接通过废弃主存中的修改数据以及已写入稳定存储的数据,无需做特别恢复操作。

Shadow-paging方法在书中提到在商业系统不常用的原因,虽然简单,但是提交时直接将整个页面写入稳定存储,需要耗费大量的IO操作,涉及大量的随机写,在机械盘时代必然会有其劣势。

基于日志完成中断

基于日志完成中断操作时,事务管理器需要从日志记录的的最后一个更新开始,用前像替换已更改的数据文件。

实现中断操作的问题在于,顺序查找日志中的更新事务效率低下,所以在需要实现一份事务与事务最后一条执行日志的匹配关系,同时事务的每条日志也要记录事务的上一条位置的指针(文件指针?),便于从后往前还原前像。

基于日志完成恢复

基于日志完成恢复,仍然是通过从后向前扫描日志进行,直到完成到检查点。

原因在于,最后一条日志可以明确事务是否已提交。中断的事务会被丢弃,并恢复前像;已提交的事务则会检查并写入数据;而运行中的事务,则会检查并写入后像,继续运行这一事务。

恢复时会阻塞所有新事务请求。

日志恢复速度优化——模糊检查点

核心在于,正常运行时写入检查点之前,脏页面已经全部写入。写入操作在系统空闲时进行。由于写入新检查点的前提是之前一个检查点之前数据已经完成写入,所以检查需要从第二个检查点之后进行。

第8章 两阶段提交

两阶段提交的处理对象

应对多个资源管理器的事务操作。

2PC的四个通信指令

REQUEST-TO-PREPARE:协调者->参与者

PREPRARED:参与者->协调者(失败则发送NO)

COMMIT:协调者->参与者

DONE:参与者->协调者

然而,任意阶段出现问题时,协调者可能还会发出ABORT指令,让参与者放弃事务,解锁资源。

2PC PREPARE

2PC中PREPARE所做的操作,是持久存储了事务的余像(afterimages)。

参与者与协调者的等待时机

参与者需要在不明确收到COMMIT/ABORT指令时进行等待(参与者可以请求协调者要求指令状态)。

协调者则需要在未收到DONE消息时进行等待(然而协调者还会定时要求参与者反馈状态)。

参与者与协调者写入日志的时机

参与者:PREPARED与DONE发送之前

协调者:REQUREST-TO-PREPARE与COMMIT发送之前(REQUREST-TO-PREPARE可以优化不写入,COMMIT日志存在的前提下,可以给参与者请求执行指令时有明确回复)

2PC可以使用三轮通信的条件

  • 只有一个参与者且参与者没有独立的准备阶段

可以在REQUEST-TO-PREPARE这一个阶段完成之后,将协调者的角色转移到参与者,通过新的协调者(即参与者)完成本地事务之后,发送COMMIT,驱动新参与者(原协调者)发送DONE消息,完成整个事务流程。由于角色变更,新协调者(即参与者)必须要等待DONE消息

合作终止协议

处理参与者者宕机恢复而此时协调者也宕机的情况,通过了解其他参与者收到的通知,决定本参与者执行的操作。参与者告知自己收到的状态,未收到REQUREST-TO-PREPARE的情况的,需要回复ABORT指令,而已PREPARED的,因为不知道原协调者的指令,需要回复UNCERTAIN。
编写 October CMS Form Widget


概述

近期接触 Laravel 这一框架之后,对使用便捷性和功能的丰富感到十分满意,同时开发者与相关的社区都相当活跃,这样的框架算是相当之理想的了。

了解了框架的使用之后,自然是希望能够找到这一框架构建的应用进行进一步的学习。CMS作为常见的系统,模式上个人理解起来比较容易,同时涉及面也比较多,同时还有一定的实用性,学习起来有价值。

使用 Laravel 的 CMS 不少,有本文的主角October CMS、Asgard CMS、Lavalite,但是后续的这些,无论从 GitHub star数目上,还是更新频率上,以及社区活跃度上,完全无法与 October CMS 相提并论。

于是决定简单了解一下October CMS(以下将会用October表示,二者不做区分)。希望通过开发一个表单部件的方式,开始二次开发的学习。

本文写作的前提是:

  • 使用过基本的OctoberCMS的Ajax框架
  • 基本了解后端管理界面的组织方式
  • 了解基本的jQuery/CSS知识
  • 了解基本的Laravel使用

需求

October宣传自身是一个简单、现代、以人为本、通用的、可拓展的、有趣的、可靠地、易学、节省时间的CMS。

对于OctoberCMS,对于一对多的关系,可以在model层进行处理。

然而,处于对体验优化的考虑,简单的关联记录的效果并不能满足。譬如需要完成一个相关文章的编辑表单,如果能够以card的形式展现相关文章的头图,标题,摘要等内容,那么会更加便于后台人员的操作,提供更好的体验。

同时,可以通过这一个简单的表单插件,熟悉October CMS表单插件的二次开发。

总而言之,需求如下:

  • 开发一个相关记录的表单插件
  • 表单插件可以显示相关记录的头图,标题,摘要
  • 相关记录可以调整顺序

OctoberCMS 表单部件

OctoberCMS的有一类组件,被称为Form组件,为后台操作数据提供了极大的方便,通过配置各种Form插件的组合,可以对数据进行操作。

常规的管理界面的开发,一种模式是通过编写接口,提供修改对应数据的功能,并且前端开发需要构建对应的操作界面。对于CMS系统,这样无疑是一个低效的行为,使得管理平台开发也成为了开发工作的一大负担,提供更为简便的管理平台开发方式,对于减少开发工作量有很大意义。

OctoberCMS的表单部件通过yaml配置文件的形式,将数据库字段与前端编辑表单部件关联起来,为快速构建针对于数据的管理界面提供了可能。

针对于基本的字符串,时间选择器,富文本编辑器,单选/复选框,OctoberCMS也都默认提供了。

组件设计

对于表单部件,功能上可以一言概之,即通过图形方式构建JSON格式的字符串,并写入数据库。

设计细化

细化需求来说,关键点在于表单,数据格式,图形界面。

对于表单,最简单的情况即通过一个input标签,在进行form提交时,带上需要提交的数据。

对于数据格式,我们需要记录的是相关记录的数据库中的自增ID,存储格式会整编为JSON格式。

对于图形界面,考虑到操作的便捷性,同时考虑到显示足够的有效信息,通过显示blog的头图、标题、摘要等信息的card的形式,表现关联记录。

进一步细化[表单]

对于表单来说,只需要确定表单中的name属性即可。

新增的情况,无需填充记录的默认值,而在更新的情况,则需要进行填充,相关PHP代码的说明会在后续提及。

进一步细化[数据格式]

选用JSON作为数据格式,记录各个关联记录的自增ID。

进一步细化[图形界面]

同时显示头图,标题,摘要,通过card形式展现。

操作上,需要有增加,删除,调整顺序三种。

  • 增加操作可以通过弹出记录列表的形式,选取后展现。
  • 删除则直接通过点击card上的删除按钮/文字即可。
  • 调整顺序通过前移/后移按钮完成。

组件目录结构

OctoberCMS的表单插件需要符合一定的目录结构规则。

可以通过直接创建对应的目录以及文件,也可以通过内置的工具进行初始化:

rainlab.blog 是将要创建这一组件的插件的名称,这里可以换成自己插件的名字。关于插件,参见OctoberCMS的手册。

自动建立的目录结构如下:

文件不多,简而言之,RelatedRecords.php用来描述表单部件以及编写处理逻辑,relatedrecords.css自然是控制表单后台操作样式,relatedrecords.js则是实现表单项目在后台的前端操作逻辑,最后partials中的_relatedrecords.htm则定义了表单部件在后台的html展示部分。

如果不想通过内置工具生成表单部件,同样也可以直接在对应plugin的目录中中的widgets子目录中直接新增插件的方式完成,仿照October默认的modules/backend中表单插件的结构即可:

本文的demo即是通过这种方式生成的,结构如下:

可以看到,二者并无太大差别,都需要有css/js/partial以及主要的逻辑所在的.php文件,后续以demo中的文件组织结构进行描述。

组件实现细节简述

主要逻辑文件RelatedRecords.php

这一文件要直接放置于widgets的目录之下。

需要继承Backend\Classes\FormWidgetBase这一基类,同时我们需要实现一些关键的方法,以便完成逻辑以及正确显示组件。

下面,将会说明几个关键的方法。

init()

init()方法顾名思义,即初始化表单部件,一些组件自身需要进行的变量定义,参数定义等操作可以在这里编写。

在使用过程中,每个表单部件都或多或少有一些自定义的参数,譬如富文本编辑器的大小等,这些参数通过yaml文件配置,但是如何才能在表单部件中的读取到呢?

可以在init()中调用fillFromConfig()这一成员方法,通过数组的形式,将参数名传入,之后将会出现同名的成员变量,其值就是传入的参数名称。如果没有设定,那么也可以指定默认值。

为了完成需求,我们需要允许配置:

  • titleField card的标题域数据库字段名
  • imageField card的图片域数据库字段名
  • contentField card的正文域数据库字段名
  • modelClass 需要操作的Model名称
  • whereClause 查询数据时的WHERE子句内容
  • recordsPerPage 弹出列表页每页显示个数

在实际使用中,在models/yourmodel/下的fields.yaml文件中指定使用这一表单部件时,可以通过指定这些参数的形式,影响展现以及效果,形如:

render()

render()方法,即完成组件的渲染,如果已经设定好了模板中需要的值,那么只需要通过makePartial这一个成员方法即可对当前组件渲染完成。

实现以上两个方法之后,几乎这一组件就能基本上完成数据获取并展现的功能了。其他方法,也可以按照默认生成的文件的模式进行组织。

模板文件_relatedrecords.htm

模板文件作为一个partial,文件名需要以下划线开头,放置在组件的partials目录下。

由于实际要修改的数值是一个JSON格式的数组,提交时,实际上是作为表单的一对键值。为了完成表单提交,需要设定input标签的name属性。

那么问题来了,如何才能设定正确的name属性呢?

OctoberCMS框架在实现表单部件时,会根据表单部件所对应的Model和列的名称,生成key的名字,即input标签的name属性,可以通过成员变量formField的方法getName()获取。

在主逻辑文件RelatedRecords.php的render()(或者其他被这一方法调用的方法之中),为name属性赋值:

在partial中进行相应变量赋值代码编写即可。

而展现上,使用了部分materialize的样式,实现了图文card的显示效果。

弹出列表模板文件_list_related_records_sample.htm

图文card的底部,有添加记录的按钮,但是如何才能最便捷的展现出可以加入的记录呢?

这里可以借用OctoberCMS内置的一个特性:Remote popups。

实现简要说明

想要通过列表展示数据对于OctoberCMS来说简直是轻而易举。从操作步骤上来看,可以描述如下:

  • 点击添加
  • 触发Ajax请求,请求对应Controller上的方法
  • 对应方法获取指定数据,渲染partial返回

Ajax请求如何能够返回并显示html呢?作为OctoberCMS的一个重要特性,简要来说即通过特定的请求方法发出请求,指定操作的handler。这里可以通过js完成。

参见下的assets/js/relatedrecords.js文件:

通过popup方法,指定了handler为onLoadRelatedRecords方法。

handler方法归属的Controller,即当前编辑对象所对应的

Controller,所以,需要在Controller中实现对应的同名方法。demo中编辑的是Sample这一个对象,那么方法实现起来将会类似:

考虑到不能重复加入关联记录,所以每次请求要通过excludeIds传入已加入的id,进行排除。

通过popup方式弹出列表之后,选择加入这些操作就相当容易实现了。

其他如前端的操作、样式的编写等等不在赘述。

注册表单部件

完成上述工作之后,还需要关键的一步,即在Plugin.php中的registerFormWidgets()方法注册编写完成的组件。

组件效果

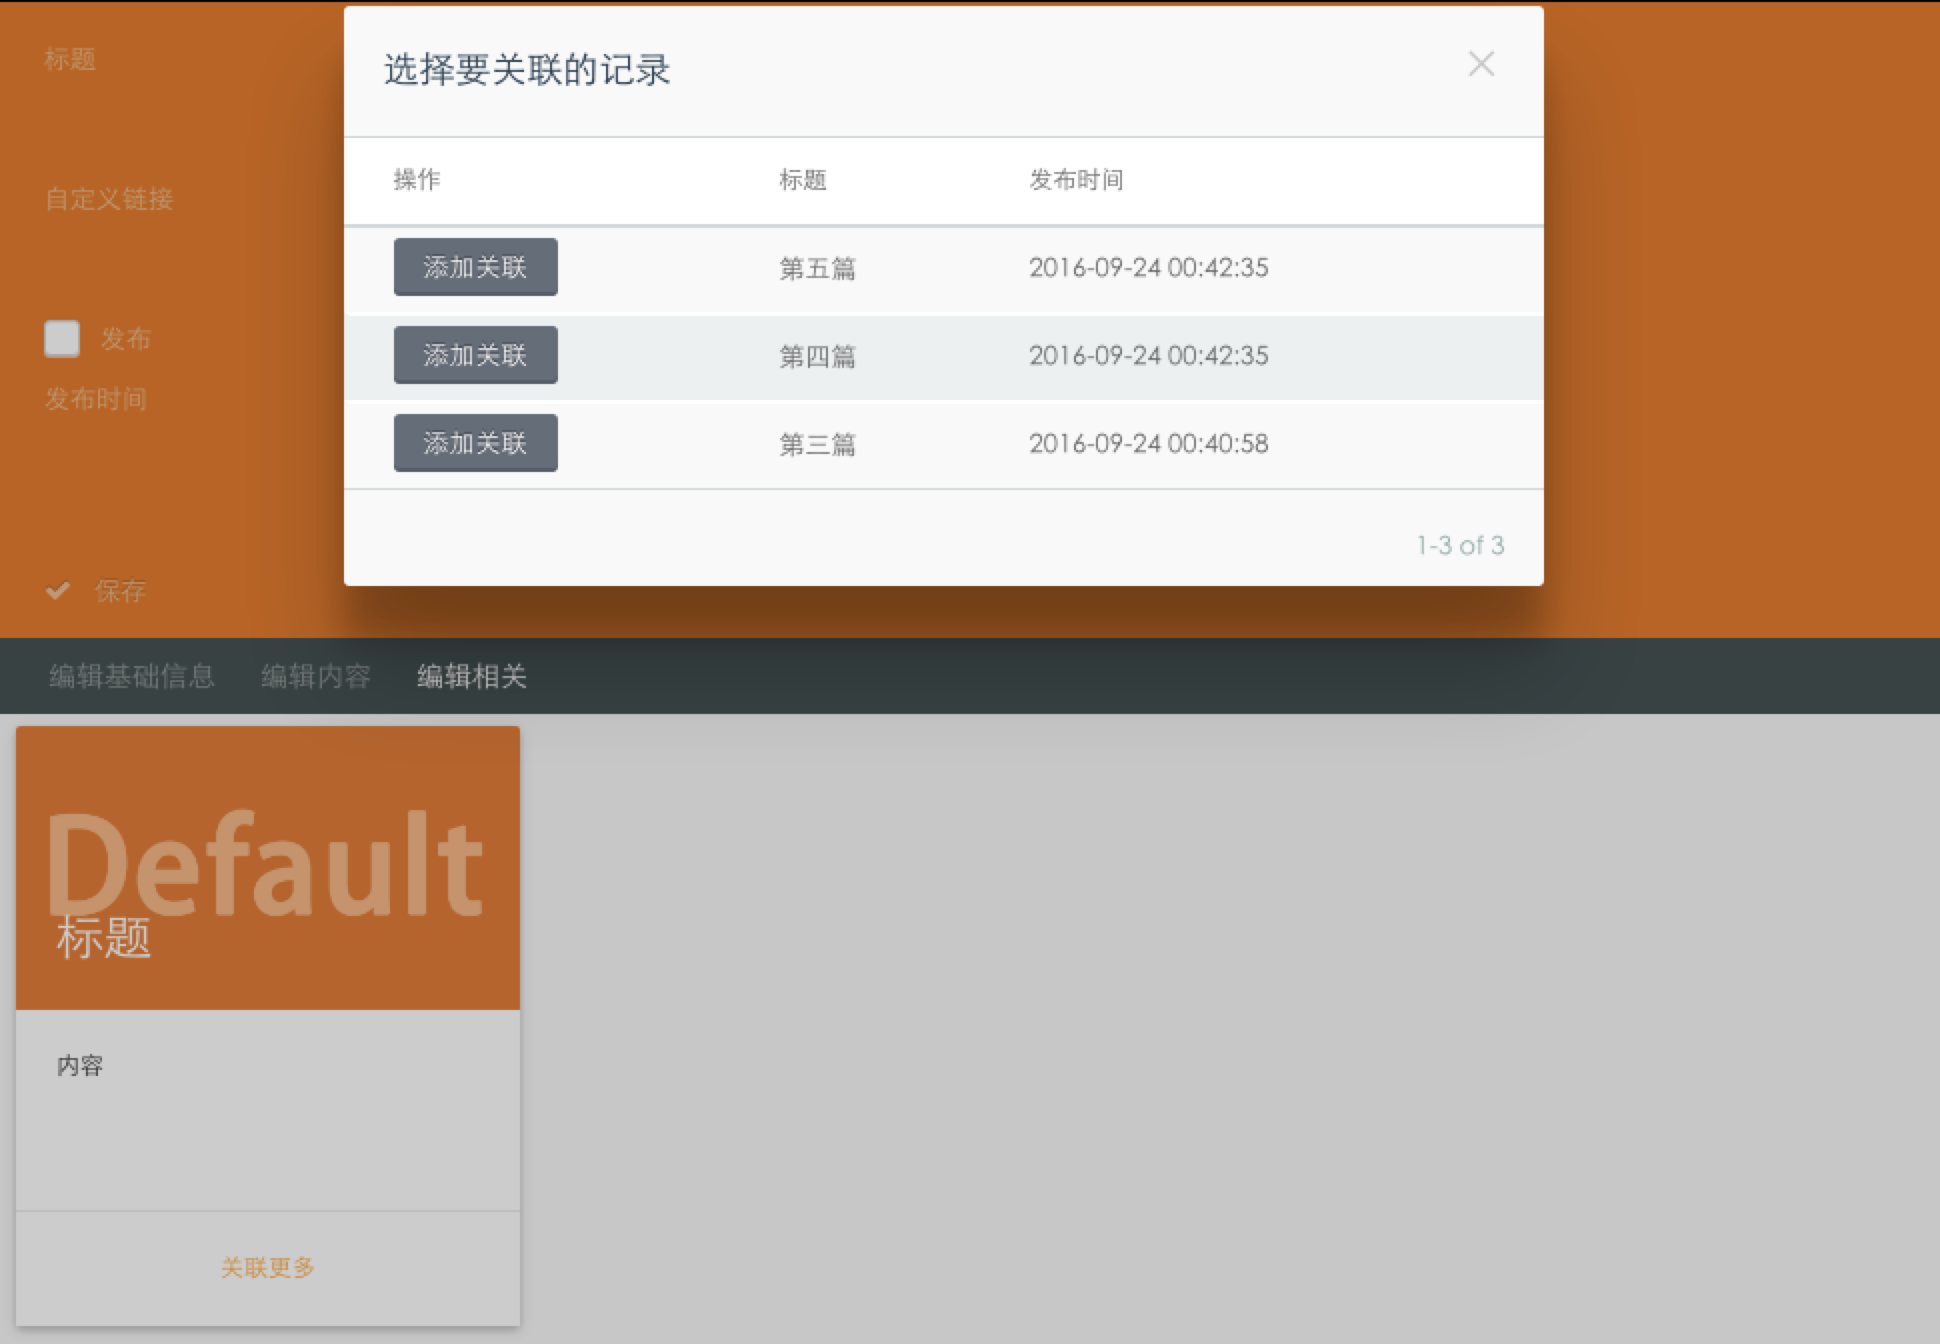
通过弹出的Modal窗口添加关联:

select related records

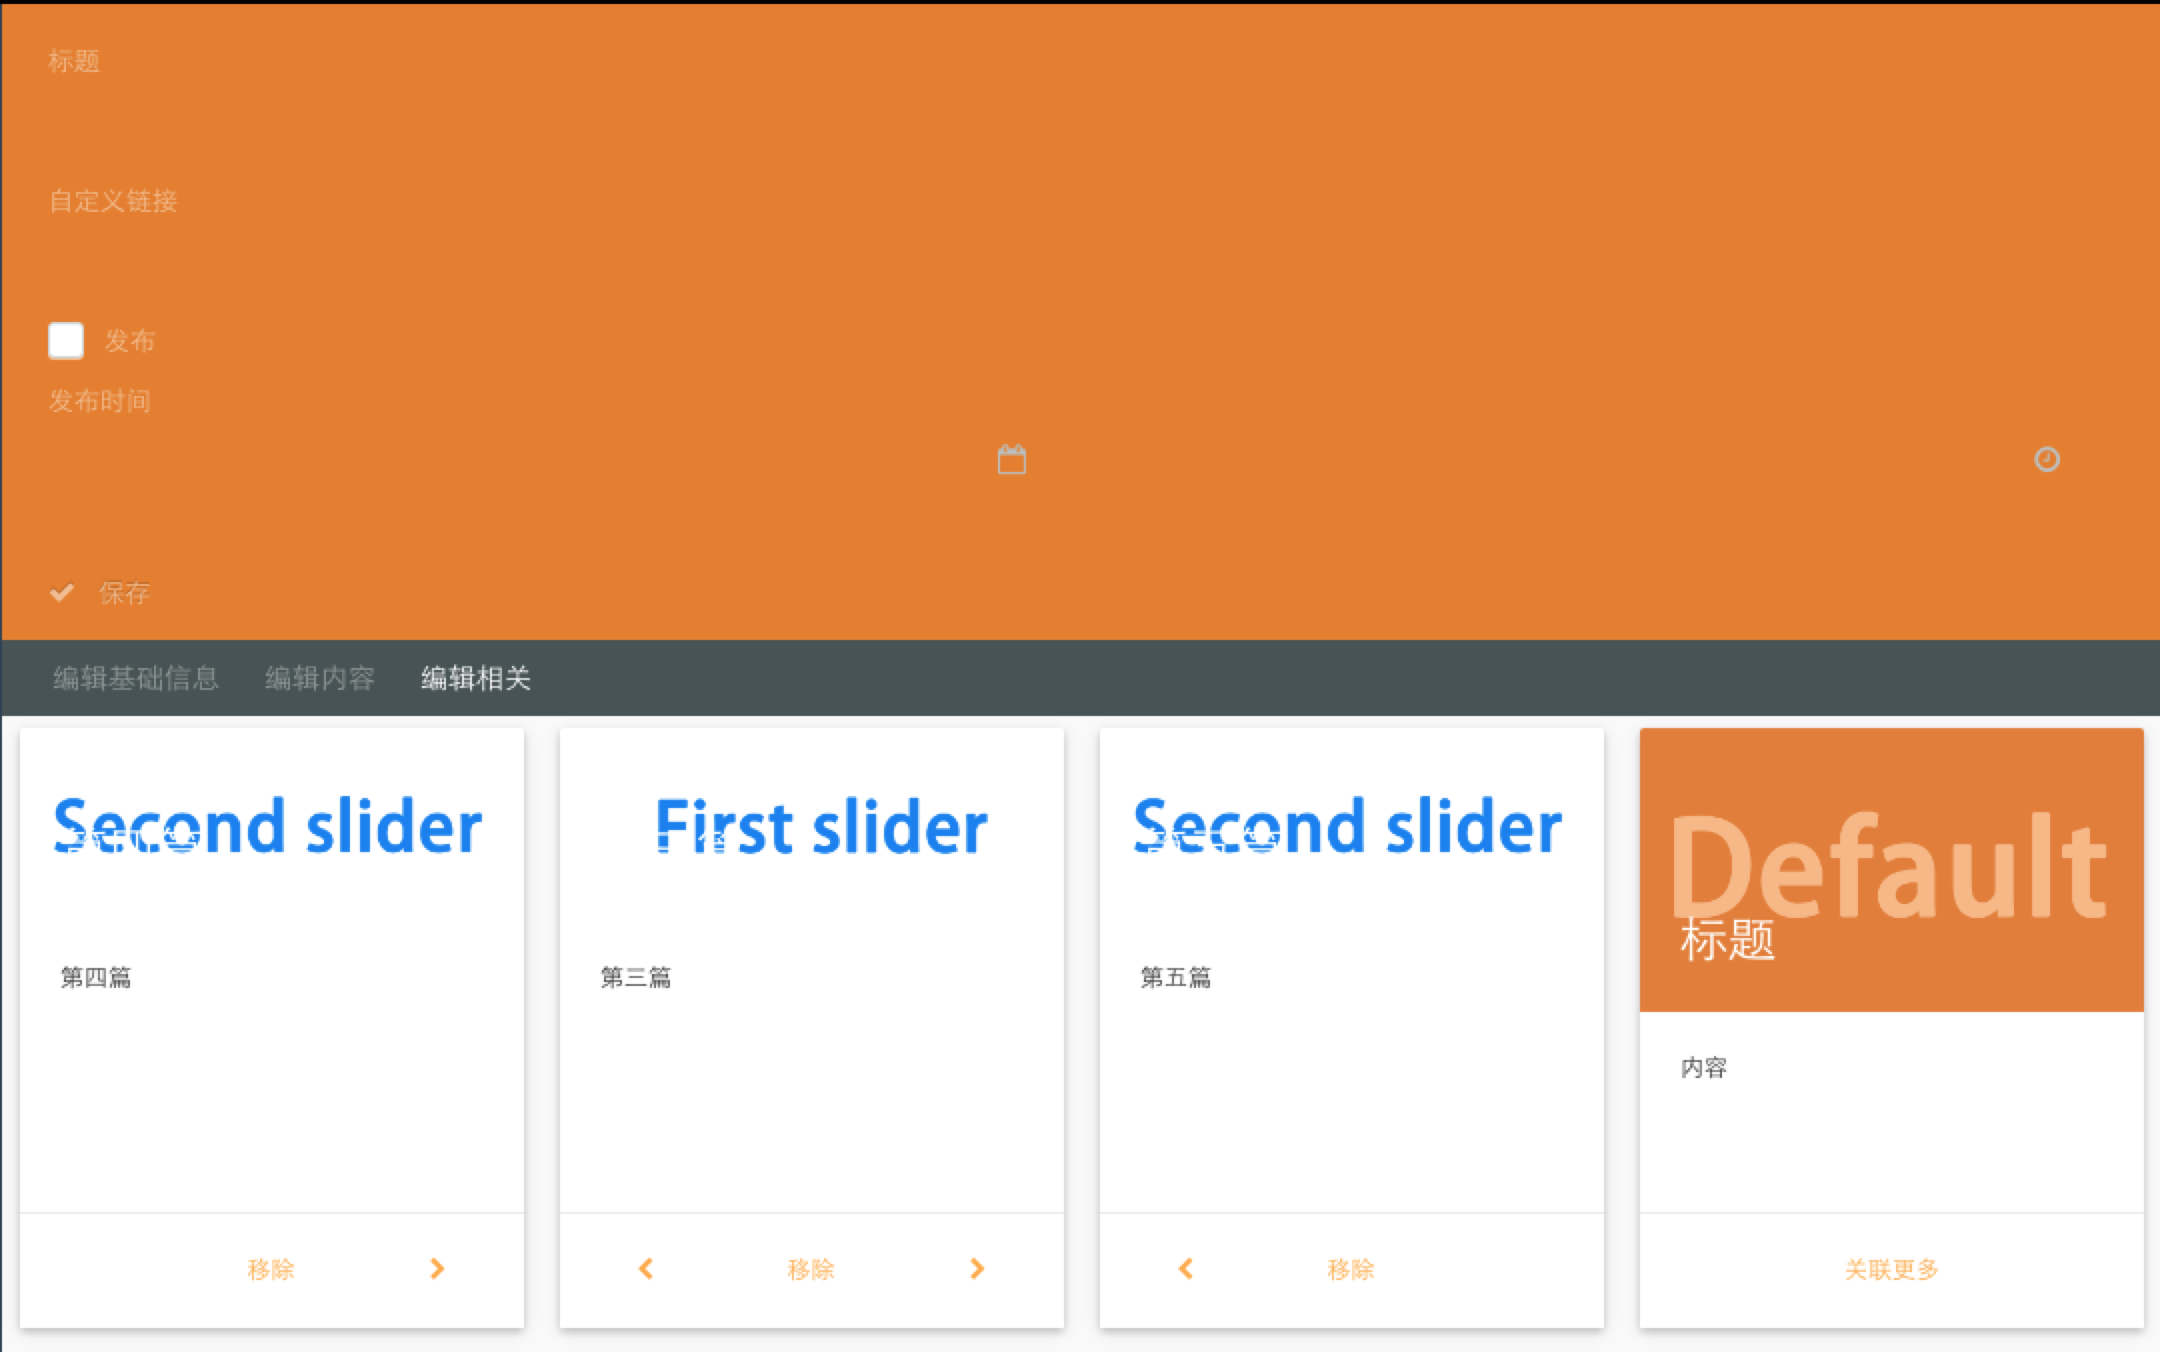
选择后可供调整顺序或移除:

selected

《从自我苛求中解放出来》


概述

《从自我苛求中解放出来》是弗雷德里克•方热 (Frédéric Fanget)的一本出版书籍。这位任教于法国里昂第一大学的精神科医生、心理治疗师也是一位畅销书作家。

微博上看到@郝景芳 的推荐,决定购入阅读。

想要让所有人都能够满意,希望能做好每一件事,似乎是很多人所期望的。但是事与愿违的情况会远比想象中的做,太过于在意他人的感受,陷入对自己的不完美的懊悔之中,给自己带来了痛苦。

各个地方不乏对于悦纳自我,接受缺陷的,拜托焦虑这类的说辞,但是具体的实现方式却语焉不详,这本小书的优势就在于此。没有说教的成分,语言上的通俗让人易于接受,而篇幅也比较适中。

个人的内心的正确认识是个很困难的事情,另外没有学习过类似的课程,自己尝试一下分析消化读到的内容。

笔记

认同书中最后提到的一个等式:

尤其是身处的环境,多次证明了在当前的情况下,选择给生活带来的影响相当巨大,职业上来说更是如此。看到了选择带来的巨大差距之后,焦虑的放大系数会变得更大,很多时候会更加的畏首畏尾。

然而做出选择并不一定是让自己最愉快的,往往都会被内心自我苛求的声音给勒索,原本能保护自己的焦虑成了伤害的来源。

这个时候使用工具一定程度上可以帮助分解问题,找到办法打破或者改变恶性循环。

认知概念化

作者提出的认知概念化方法,一个实现的方式,就是通过循环图的形式将其模型化,在可视化问题的各个阶段和状态流转之后,辅助认识问题。

做出选择一般都事出有因,大多数是来源于一个人生准则,比如完美主义,书中举例一位以“做事求赞”为生活准则的女性的例子(人生准则细则的原文是必须做出超乎寻常的事),例子的主角为了避免被人否定,而季度的追求完美主义,希望万事都是做的完美。

通过认知概念化的方法,会发现造成例子中的主角内心不自由的根源在于扭曲了信心和价值感的获取和渴望出色的完成事情的关系,在周而复始的过程中,这个扭曲会不断的加强,从而绑架了个人。

实现认知概念化的方法,简单概括为:

  • 确定具体情境
  • 找到这一情境下行为准则
  • 找到对行为的影响
  • 找到对情绪的影响
  • 推导出认知扭曲的结果
  • 最后总结出对个人的影响

生活中的一些场景,个人按照这一方法分析,如内向的人被拉去聚会结识新朋友,可以是:

  1. 具体情境:结识新朋友
  2. 行为准则:必须外向,否则不会受欢迎
  3. 对行为的影响:尝试与他人热烈的沟通,获取认同
  4. 对情绪的影响:满足
  5. 认知扭曲:因为变得外向,所以能够结识新朋友
  6. 对个人的影响:要改变自己内向的状态,迎合大家

事实上,人际关系的建立,个人也一定程度上决定于个人的内在特质,内向外向的性格固然影响巨大,但是因为这一人生准则而痛苦不堪,是没有必要的。

带来问题的人生准则

什么样的准则可能会带来问题?

简答来说,如下句式的可能会带来问题:

  • 必须
  • 应该
  • 如果……才会……

更容易的一个概括方式,大概就是书中提及的,美国认知疗法先驱Alber Ellis提出的musturbation了,第一个音节的must概括了这类认知的特性,即一个人给自己的定下的不可改变的人生准则。

在与准则的共处过程中,如果当事人被压制到毫无回旋余地,那么这些准则就变得有害。痛苦也就随之而来。

概念化模板

在说明这一个工具之前,先说两个概念的个人理解:条件认知模式与无条件认知模式。

条件认知模式是受到外界因素的影响而产生的对事物的看法,而无条件认知模式则是自发的产生的对事物的看法。条件认知模式的更易于接受和理解。

给个人带来困惑的问题实际上可以总结出一个循环,即处理A问题时,如果选择行为B则带来不良后果C,会影响我的正面情绪D,增强负面情绪E,最后在类似A问题再次到来时,心理上会推广这一个循环的适用范围,迫使自身选择不利于自身的行为B。对于让自己产生焦虑的问题,可以尝试总结出这一个循环,看看是否存在口是心非的情况,解决的方法是直面现实,从保护自己的利益的方面做出考虑。

童年生活中往往会影响无条件认知模式,这类焦虑产生时,对自身提问是能解决问题的好办法,多问为什么可以帮助分清现实和内心虚构出来的影响。

总结

选择和焦虑共处,遭遇焦虑时寻找出焦虑产生的循环,针对当中的准则多问为什么。

肯定自己,勇敢说不,是两件最艰难的事情之一。

最后,最重要的,不要过度关注焦虑本身,思绪被焦虑占据,就没有了生活的空间。

简要了解 MySql 5.5/5.6/5.7/8 出现的新特性


概述

中秋假期的前夕的9月12日,MySQL 8.0.0 放出了 Development Milestone Release。是开源数据库的一大新闻。

要知道MySQL的上一个版本号仅仅是 5.7。在MySQL归属于Oracle公司之后,版本号的飞速提升也开始了,按此趋势,预计不日将会赶超Oracle自家商业数据库产品……

发布之际,简要的了解和比较一下 MySQL 5.5/5.6/5.7/8 之间的区别和特性。

如有错误,烦请指出。

MySQL的开发周期

在比较之前,首先提一下MySQL的开发周期.

MySQL一个大版本的开发,大致经历如下几个阶段:

  • Feature Development
  • Feature Testing
  • Performance Testing
  • Lab Releases
  • Development Milestone Releases
  • General Availability Release(GA)

Feature Development

也即是所谓的特性开发阶段。这个阶段是常规的功能点确定,代码开发,完成CR以及QA等常规的开发流程。

在一系列的测试以及bugfix之后,当QA “signs off” 即测试通过之后,会合并到TRUNK之中。

Feature Testing

即特性测试阶段。

特性测试的阶段,从质量保证的角度出发,MySQL的测试工作将会有以下的关注点:

  • 完成新特性的基本测试工作
  • 未出现性能衰减/特性的倒退
  • 至少达到80%的代码覆盖率

一个新特性达到要能被合并到TRUNK之中,需要满足如下条件:

  • 没有任何已知的错误,包括那些微小的错误
  • 没有任何已知的性能衰减/特性的倒退
  • 代码覆盖率达到预期
  • 自动化测试集中需要有这一新特性的回归测试用例

Performance Testing

作为应用的基础组件,性能是绝大多数开发人员都在关注的问题。在特性测试完成之后,将要进行的是性能测试。

性能测试主要关注两个指标:吞吐量和响应时间。

针对于吞吐量的测试,会有如下的特点:

  • 并发测试范围从8到1024个连接
  • 使用诸如sysbench这类开源软件,进行简单OLTP(基本的事务处理)的测试,每个测试时间在5-10min范围内,随着数据集以及系统配置而定
  • 针对特定场景也会有相应的测试用例
  • 测试数据会被存储到数据库中,以便比较或者确定测试的基准值

而对于响应时间的测试,则会有如下的特点:

  • 在单个被测试线程上完成测试
  • 准备两方面测试用例,分别考验计算复杂型场景和IO密集型场景

Lab Releases

实验室发布是在用户对某一特性有着强烈的兴趣时,发布的快照版本,通常还没有合并到TRUNK之中。

实验室发布版本存在的特性,并不会保证在正式版等版本中存在。如果想要尝鲜,可以访问labs.mysql.com。

Development Milestone Releases

上述步骤结束之后,到了DMR阶段,也就是本次 8.0 版本所处的阶段。

DMR将会是一个重复迭代的阶段,下一个DMR版本将会包含上一个DMR版本的新特性或者功能修复。并且,DMR了的MySQL将会支持所有的平台,DMR状态下的MySQL的代码质量是达到了可供发布的水准的。

DMR看起来像是游戏的公测版本,每3-6个月会发布一个版本,每个DMR版本的MySQL会有一个特性需求收集截止时间点,新增的特性会历经开发、测试的历程,合并到TRUNK之中,变为下一个DMR。

总之,DMR的目的就是能够时常发布,让用户和客户能够反馈需求,体验新版本。

General Availability Release(GA)

终于,在n个DMR之后,MySQL表现稳定,需求“无可”增加,客户满意,质量过关。

基于最后一个DMR版本,会发布GA版本,即我们可以“放心”使用在生产环境中的MySQL。

每个GA版本的发布周期间隔在18-24个月。

版本比较

对于这些MySQL版本,如果想要了解之间的差异,一个可行的办法是阅读GA版本的Release Notes。

MySQL 的近几个版本发行时间间隔并不太大:

版本 GA 版本发布时间
5.5.8 2010-12-03
5.6.10 2013-02-05
5.7.9 2015-10-21

大约2年会有一个较大更新的版本会发出。

新特性

对于使用者而言,新特性应该是关注的第一焦点。下面会针对版本列出一些个人认为有特点的新特性。

5.5

InnoDB 作为默认存储引擎

InnoDB 因为支持事务、行级别锁而广为人知,并广泛应用。但是在之前的版本中,InnoDB并不是默认的存储引擎。在5.5中,InnoDB成为了默认的存储引擎。

半同步复制

半同步复制(Semisynchronous Replication)在MySQL 5.5中被支持(以插件形式实现)。

默认的MySQL通过异步模式进行复制,主库写入binlog之后,从库不一定能够被读取并处理,因为写入成功只是说明在主库上成功。主从不同步带来的问题相当之多,提升了开发难度。

而半同步复制则是主库需要有至少一个半同步从库,当一次写入操作进行之后,至少在主库和至少一个半同步从库上都完成了写入之后,用户才会收到已成功的信息。

半同步复制在这一程度上提高了数据的安全性。

5.6

MySQL 5.6 的主要变化在性能优化方面。有一些小的新特性也值得关注。

表中可以设置多个Timestamp属性

MySQL 5.5 中,如果设定多个Timestamp的属性为 ON UPDATE CURRENT_TIMESTAMP 时,这样的操作是不能完成的,这样的需求,通常要在业务代码中完成。

而到了 MySQL 5.6 中,这样的操作可以直接通过设定字段的属性即可完成。

InnoDB 支持全文索引

全文索引 MyISAM 存储引擎之前相对于InnoDB的一个“优势”特性,在MySQL 5.6中不复存在。

针对字符串型的字段(CHAR,VARCHAR或者TEXT),可以选择在创建表时增加这个类型的索引。也可以后续添加。

InnoDB的全文索引也使用的是倒排索引的设计,分词完成的词汇将会存储在独立的索引表之中。当包含全文索引的字段插入之后,会进行分词,同时先将分词结果进入内存缓存,之后再刷入索引表中,避免一次写入带来的大量附加的小规模的更改操作。

多线程复制

在MySQL 5.6中,会针对每一个数据库开启一个独立的复制线程,如果数据库压力平均的话,对于主从同步延迟会有一定的改善。但是如果数据操作都在一个数据库上,就不会有太多显著的效果了。

加入全局事务ID(GTID)

在MySQL 5.6前,如果从库宕机,重启之后需要进行同步,需要知道binlog文件名已经位置。

在MySQL 5.6中,加入了GTID(global transaction identifier)。GTID由source_id和transaction_id构成,source_id标识主库,transaction_id标识在数据库上进行的事务,格式即GTID = source_id:transaction_id。

在加入GTID之后,重启从库之后,不需要重新进行位置的指向,只需要连接到主库即可,剩下的步骤将会是自动的。

5.7

InnoDB

InnoDB地位进一步增强,这一次系统表已然变成了基于InnoDB存储引擎的表。并且也不能禁用InnoDB存储引擎了。

增强的多线程复制

在5.6中添加的多线程复制的增强版,针对每个数据库可以增加线程数进行同步,对5.7.9版本,在实际使用中,在机械盘的服务器上,原有业务高峰时主从同步延迟在10-30分钟左右,使用5.7.9之后基本实现了数据上的同步。

多源复制

即将多个主库的数据归并到一个从库的实例上。

之前的MySQL,每个从库都只能拥有一个主库,如今MySQL提供了官方的解决方案,用于将多个主库的数据同步到一个从库之上。

多源复制有一个关键概念,即频道(channel)。频道指代一个主从库之间用于同步binlog的连接,通过新增的FOR CHANNEL子句,指定一个非空的频道名称,按照先前版本的连接主库的方法,即可实现多源复制功能。

需要注意的是,当多个主库均写入同一张表时,是要自行处理主键冲突。

JSON数据类型操作

PostgreSQL 9.3开始,PostgreSQL中JSON成为了内置的数据类型。

作为被广泛使用的数据组织格式,之前版本的只能讲JSON格式数据按照字符串形式进行存储。

到了5.7之后,JSON支持也被加入。

JSON中的字符串在MySQL中会被转化成utf8mb4的字符集,给携带诸如emoji字符的数据的存储带来了方便。

对于JSON数据的结构特性,MySQL中对JSON的查询需要借助path expression以及JSON_EXTRACT方法进行查询。path expression的简要要点如下:

  • 以$符号开头
  • .符号紧接着的是对象中的key
  • [n]中表示的是数组中的第n个元素,n>=0
  • .[*]表示一个key下的所有对象
  • [*]表示一个key下所有的数组
  • exp_a**exp_b则表示path中带有exp_a与exp_b的值
  • key如果包含特殊字符,需要通过双引号包裹起来

更多操作参见手册。

innodb_buffer_pool_size参数动态修改

在之前的版本中,innodb_buffer_pool_size调整之后,需要重启数据库实例,这个对于线上业务几乎是不可接受的。硬件性能强悍的服务器,调整这一参数之后,MySQL的表现会有较为客观的提升。

到了MySQL 5.7,这一参数终于可以在线调整了。

初始化工具

在之前的版本中,初始化系统表一般都会使用mysql_install_db脚本,到MySQL 5.7之后建议使用mysqld --initialize完成实例初始化。

在通过mysqld --initialize进行初始化时,需要加上--initial-insecure才能实现空密码登录,否则会将初始化的默认密码写入到错误文件中。

初始化完成之后,还需要使用MySQL 5.7版本的客户端登录,并且修改默认密码。

8.0

作为版本号突飞猛进的一个版本,在MySQL 8.0中新增了如下的特性:

用户角色

8.0中将会增强账号管理的功能,提供角色这一概念,即能组合权限,批量授权给某一用户。

增强的InnoDB

  • 自增id会写入到redo log中,这一改动使得数据库重启之后的自增值能恢复到重启前的状态
  • 增加了死锁检测开关innodb_deadlock_detect,可以在高并发系统中动态调整这一特性,提升性能

增强的JSON操作

  • 增加了->>操作符,使用这一操作符等同于对JSON_EXTRACT的结果进行JSON_UNQUOTE操作,简化了SQL语句
  • 增加了按JSON数据组织返回数据操作的两个方法:JSON_ARRAYAGG与JSON_OBJECTAGG。JSON_ARRAYAGG将某列的值按照一个JSON数据返回,而JSON_OBJECTAGG将列A作为键,列B作为值,返回一个JSON对象格式的数据

后续将会继续更新本文。

相关

[1]: What’s New in MySQL 5.7? (So Far)

InfluxDB使用笔记


概述

InfluxDB是 InfluxData 公司发布的一款开源时序数据库产品。

关于时序数据库,除了常用的ElasticSearch之外,InfluxDB也是一个选择。

InfluxDB 使用 go 语言编写。个人认为几个外在的优点在于:

  1. 无特殊依赖,几乎开箱即用(如ES需要Java);
  2. 自带HTTP管理界面,免插件配置(如ES的kopf或者head);
  3. 自带数据过期功能;
  4. 类SQL查询语句(再提ES,查询使用自己的DSL,虽然也可以通过sql插件来使用类SQL进行查询);
  5. 自带权限管理,精细到“表”级别;

这些好处官网都有提及。

关键概念

手册中对这些名词有了详细的定义,这里稍微提及一下。

time

Time 在 InfluxDB 中的每一行数据中都会存在。

Time 即数据生成时的时间戳。

类比更为熟悉的 MySQL 来说,InfluxDB 中的 Time 几乎可以看做是主键的代名词了。

field

Field 在 InfluxDB 中是必须的数据的组成部分。

Field 未被索引。这意味着如果查询field的话将会扫描所有数据,找出匹配项;手册上也建议不要在field中存储将会频繁查询的数据(存储区分度更高的数据)。

类比 MySQL,Field 可以看做没有索引的列。

tag

Tag 在 InfluxDB 中是可选的数据组成部分。

不同于 Filed,Tag 的数据会被索引。

类比 MySQL,Tag就是有索引的列。

measurement

InfluxDB 是时序数据库,时间数据 time 与 Tag 以及 Field 组合成了 Measurement。

类比 MySQL,Measurement可以看做的是表。

retention policy

应用程序记录日志的情况下,如果没有关注,很有可能会出现打爆硬盘的情况出现。运维同学一般会在服务器上部署自动清理脚本。

在InfluxDB中,合理的设置了 Measurement 的 Retention Policy 的情况下,无需太过担心磁盘被打爆的情况。

Retention Policy 可以看做是数据清理策略。基础应用个人认为应该关注如下的一些参数:

  • DURATION,即保存时间,有 m h d w INF几种,即分,小时,天,周以及无限(Infinity);
  • REPLICATION,即副本数,即会有多少份副本保留在集群之中。

point

Point 即同一时间戳产生的数据的集合。

series

Series 表示Measurement、Retention Policy、Tag都相同(tag的名称与值)的一组数据,Field不在考虑衡量范围之内。

基本操作

基本操作简单提及数据的 CURD 以及数据库管理方面的一些使用方式。

CURD

CREATE

在已创建数据库的前提下,新增数据,可以通过两种基本的方式进行数据的写入:

  • CLI
  • InfluxDB HTTP API

CLI

CLI 自然与 MySQL 类似,通过 InfluxDB 提供的 CLI 工具,使用类 SQL 语句进行写入。

但是 CLI 毕竟不是使用 InfluxDB 作为后端存储的好方式,InfluxDB 也提供了非常方便的HTTP API 供开发者们使用。

InfluxDB 的特点是无结构的,即文档中提到的 schemaless,可以随时的动态增添数据域和表,所以使用时直接写入,无需考虑关系型数据库中类似建表等过程。

不过,CLI 虽然不能做到随时随地的的使用,但是类 SQL 语句还是在特定场景下还是有应用空间的(例如使用默认的Web管理端)。

CLI 写入数据时,语法相当简单,只需要使用:INSERT 数据 这样的语句即可。但是数据部分有InfluxDB自己的一些协议,目前在使用的规则叫做 Line Protocol。

Line Protocol

文档中已有详细描述,这里总结一下,简单来说,个人认为可以关注如下的特点:

  • 第一个字段是表名
  • 如果有tag,表名之后使用英文逗号分隔,以k=v的方式逐个列出
  • field在前两部分之后,用空格分隔开,之后所有的field,也使用英文逗号分隔,以k=v的方式逐个列出
  • 如果要指定时间戳,那么在field之后,通过空格分隔,将纳秒级别的时间戳写入
  • 在 tag 的键,值,以及 field 的键中包含, 、= 以及空格的,需要进行转义(变为\, \= \),field 的值可以通过 英文双引号 包裹起来(但是双引号决定了这个值必然是一个字符串)
  • 数据分为 string int64 float64 boolean 几种类型
  • string 最大存储的长度为64KB
  • float64 是默认的的类型,如果整数值要存成整数,需要在数字后通过字母 i 标明

InfluxDB HTTP API

InfluxDB 启动后,会默认监听 8086 端口,在这一端口上可以通过 HTTP POST 的方式,请求 /write ,写入数据。

写入方式手册已很清楚,即将 Line Protocol 格式的的数据提交到 InfluxDB 之上。

需要注意的是,InfluxDB 在通过HTTP方式操作时,需要注意下HTTP的状态码,尤其要注意204这一状态码,InfluxDB在返回这一状态码时认为请求合理但是并未完成,当返回这一个数值是需要注意HTTP的body段中附加的错误信息。至于4xx与5xx则是真的存在错误的情况。

时序相关

既然是时序数据库,那么时间作为重要的维度需要单独一提。

通过 Line Protocol 写入数据时,如果没有指定时间,将会根据系统时间指定时间,所以手册中提到:

If you do not specify a timestamp for your data point InfluxDB uses the server’s local nanosecond timestamp in UTC.

这个和 ES 的默认行为不太相同,所以这里需要注意。

如果要人工指定时间,需要按照 RFC3389 里提及的格式指定,即指定一个ns级别的时间戳,形如1465839830100400200。

RETRIEVE

与 CREATE 这一动作相同,数据的获取同样可以通过在 CLI 中执行InfluxQL(即InfluxDB中定义的类 SQL 语言),或者通过 HTTP API 提交查询语句的方式进行。通过 HTTP API 访问的话,InfluxDB会返回JSON格式的数据。

InfluxDB使用类 SQL 语言进行查询,确实是降低了使用的门槛,类似 SQL 的 SELECT GROUP BY LIMIT ORDER BY 操作的用法参见手册。

GROUP BY

值得一提的是,作为时序数据库,InfluxDB在查询上有一些时间相关的操作,例如 GROUP BY 操作可以按照时间戳进行聚合,获得每个时间片级别上的聚合数据。即通过 GROUP BY time(interval) 方法进行聚合,interval 即支持的时间片,支持的范围有:

时间片单位 范围
u 微秒
ms 毫秒
s 秒
m 分钟
h 小时
d 天
w 周

比如 time(3d) 表示按照3天作为周期进行聚合。

同时 fill() 方法也是一个有意思的功能,使用 GROUP BY 之后,如果某个聚合的结果内没有值,可以通过 fill() 设定为自己需要的值。更详细的用法参见手册。

INTO

如果说上述的的一些操作看起来和平常使用的关系型数据库没有特别大的区别的话,我想从 INTO 开始,InfluxQL就体现出时序数据库的一些特点了。

比如机器性能数据的采集,数据点多了之后,很可能我们期望能够看到的不是单一时间点上的数据,而是机器阶段性的表现和趋势,这样的数据自然可以通过聚合具体的采集数据获得,但是为什么不直接读取已经聚合完成的数据并展现呢?重复的计算是对机器性能的巨大浪费。

通常情况下,我们可能需要编写程序完成这样的工作,但是在InfluxDB中,可以通过内置的 INTO 语句来完成,无需额外的工作。

结合手册中的例子:

即在2015-08-18T00:00:00Z到2015-08-18T00:30:00Z的时间范围内,将每12分钟在santa_monica区域的水位的平均值存入average表中。

如是,如果要了解平均值,无需重复计算原始数值。

对于实际业务来说,统计接口PV/UV的场景很适合使用这一个子句,因为阶段统计中,并不关心具体的访问用户,而是期望了解趋势(对于UV的定义需要结合实际的业务场景)。

LIMIT & SLIMIT

LIMIT 限制的是数据的行数,而 SLIMIT 限制的则是返回的 Series 的个数,如果二者都要限制,则先设定 LIMIT,之后再设定 SLIMIT。

OFFSET & SOFFSET

分页是查询数据的一个基本方式,InfluxQL中通过 OFFSET 以及 SOFFSET 进行。

类似 LIMIT & SLIMIT, OFFSET 是针对数据行的翻页,SOFFSET 是针对 Series 的翻页。

时序相关

时序数据库,自然查询的数据经常会与时间有关。前面提及的时间单位,在选定时间范围时,可以通过组合简化时间区间的确定。

例如选出当前时间前3天到5小时前的数据,那么只需要指定条件为time >= now() - 3d AND time < now() - 5h即可。

如果你愿意,也可以与 RFC3339 格式的时间做对比。

UPDATE & DELETE

InfluxDB不存在常规意义上的 UPDATE 和 DELETE 这些动作!需要注意!

InfluxDB的设计初衷是为了记录时序相关的数据,这些数据被认为是不常变的,并且是仅仅有一次写入操作的(瞬时应当是唯一的)。

综上,InfluxDB期望通过牺牲了数据的灵活性,换取了更好的写入与查询性能。

实例:grahios使用InfluxDB作为后端

grahios 是一个将 Nagios 性能数据,使用不同的后端数据收集工具(or 时序数据库)进行收集的工具。在之前的笔记 使用Grafana+InfluxDB展示Nagios监控数据 之中有所提及。

graphios 使用 InfluxDB 作为存储后端,首先完成的步骤,是将 PERFDATA 解析,之后按照 Line Protocol 拼装,发送到后端。

由于 InfluxDB 是 Schemaless 的,所以 graphios 无需进行提前建表这一操作,直接发送数据即记录。

比较让我关心的是 Line Protocol 的运用,参见提交 sha 值为 02098f 的 graphios_backends.p 的文件的667行的 format_metric 方法:

生成Measurement

使用了 Line Protocol 的情况下,输入变量path将会作为 Measurement的名称,这里的 path 即 Nagios 中的 HOSTCHECKCOMMAND 或者 SERVICEDESC Macro 的值,即检测服务的名称。例如磁盘就是 Disk。

生成Tags

所有的检测数据都会作为 tags 存在,目的应是便于查询。检测数据的格式形如:

DISK OK – free space: / 3326 MB (56%); | /=2643MB;5948;5958;0;5968

/ 15272 MB (77%);

/boot 68 MB (69%);

/home 69357 MB (27%);

/var/log 819 MB (84%); | /boot=68MB;88;93;0;98

/home=69357MB;253404;253409;0;253414

/var/log=818MB;970;975;0;980

橙色部分是 PERFDATA,将会被解析成Tags所需的格式:

/=2643MB,/boot=68MB,/home=69357MB,/var/log=818MB

由于 Nagios 中 / 一般被设定为需要转义的字符,所以,写入数据库是,可能会被转换为:

_=2643MB,_boot=68MB,_home=69357MB,_var_log=818MB

至于比如 PERFDATA 中的 WARNING CRITICAL 等标识去哪里了,可以看到提交 sha 值为8aa93b 的 graphios.py 文件的358行的 process_log方法,文件387行开始:

说明了实际上原始日志处理过后,只会有等号后的第一个数据存在。

生成Fileds

由于 Fileds 是InfluxDB数据不可缺少的一部分,但是实际上,由于没有索引的原因,查询时的成本比较大,所以 graphios 把 PERFDATA 的value作为数据的一个field value记录,个人任务因为这个value并没有足够的细节,具有足够的细节的数据已都做为tag存在。

生成时间戳

由于需要ns级别的时间戳,所以需要在检测的时间戳上乘以特定倍数即可。

查询

查询的工作,则交给Grafana这类专业的数据展现工具完成。

小结

以上是InfluxDB的基础使用笔记,数据库的诸如认证,部署,集群,以及使用上的如降采样(Downsampling)预计将会在后续笔记中提及。